Preise, Ergebnisse und Dokumentation geprüft am 24.09.2026.
Anthropic hat Claude Opus 5.5 am 22.09.2026 veröffentlicht und die zentrale Aussage ist deutlich: Opus 5.5 "arbeitet auf dem Niveau von Claude Fable 5.1 bei den meisten Aufgaben und kostet 40 % weniger im Betrieb als Opus 5."
Vergleichsartikel erschienen innerhalb weniger Stunden. Einige waren hilfreich, mindestens einer meinte, Opus 5.5 sei noch nicht verifizierbar. Daher haben wir vor diesem Beitrag die offizielle Ankündigung, die Preisseite und die Migrationsdokumente von Anthropic geprüft, die ersten unabhängigen Testergebnisse angesehen und alle Zahlen abgeglichen.
Hier steht, was belegt ist, was noch Behauptung bleibt und wie wir als Entwicklerteam aktuell vorgehen würden.
Die Kurzfassung
- Setzen Sie Opus 5.5 als Standard für Programmierung, Agenten und alltägliche Wissensarbeit ein. In den aktuellen Anthropic-Dokumenten heißt es: „Wenn Sie unsicher sind, welches Modell Sie wählen sollen, beginnen Sie für die meisten Aufgaben mit Claude Opus 5.5.“
- Nutzen Sie Fable 5.1 weiterhin für Aufgaben, bei denen es sich bewährt hat. Anthropic empfiehlt Fable weiterhin „für anspruchsvolle Schlussfolgerungen, langfristige Agentenarbeit oder wenn Ihre Auswertungen mit Claude Opus 5.5 bei höherem Aufwand nicht ausreichen.“
- Planen Sie den Umstieg von Opus 5, aber ohne Eile. In den Anthropic-Dokumenten ist es jetzt als „Legacy“ markiert, Opus 5.5 ist in jeder Preisposition günstiger und laut Anthropic wird Opus 5 nicht vor dem 24.07.2027 eingestellt.
- Beachten Sie die Einstellung für den Aufwand. Der günstige Standardwert (mittel) und die besten Benchmark-Ergebnisse (maximaler Aufwand) sind nicht identisch. Mehr dazu weiter unten.
- Planen Sie Zeit für die Migration ein. Die API enthält Breaking Changes. Allein das Ändern des Modellnamens kann zu Fehlern führen.
Welches Modell für welche Aufgabe
Wenn Sie nur eine Tabelle lesen, dann diese. Sie basiert auf den Empfehlungen von Anthropic und den unabhängigen Ergebnissen weiter unten.
| Die Aufgabe | Empfohlener Start | Aufwand |
|---|---|---|
| Alltägliche Programmierung, Code-Review, Berichte | Opus 5.5 | Mittel (Standard) |
| Schwierige Bugs, Refactoring über mehrere Dateien, komplexe Integrationen | Opus 5.5 | Hoch, dann sehr hoch |
| Langlaufende autonome Agenten, anspruchsvollste Schlussfolgerungen | Fable 5.1, nach Tests von Opus 5.5 unter hoher Last | Hoch oder höher |
| Bestehender Opus 5-Traffic | Wechseln Sie zu Opus 5.5, sobald die API-Änderungen behoben sind | Explizit festlegen |
| Großvolumige, einfache Aufgaben (Tagging, Klassifikation) | Warten Sie auf Sonnet 5.5 oder Haiku 5.5 | Niedrig |
Die drei Modelle im direkten Vergleich
| Opus 5.5 | Opus 5 | Fable 5.1 | |
|---|---|---|---|
| Veröffentlicht | 2026-09-22 | 2026-07-24 | 2026-09-01 |
| Input (pro 1 Mio. Tokens) | $4 | $5 | $10 |
| Output (pro 1 Mio. Tokens) | $20 | $25 | $50 |
| Cache-Lesevorgänge (pro 1 Mio. Tokens) | $0.20 | $0.50 | $0.25 |
| Kontextfenster | 1M | 1M | 1M |
| Maximaler Output | 128K | 128K | 128K |
| Standardaufwand | medium | high | high |
Im Vergleich zu Opus 5 sind die Input- und Output-Preise von Opus 5.5 um 20 % niedriger, die Cache-Lesevorgänge um 60 % geringer. Im Vergleich zu Fable 5.1 sind Input und Output um 60 % günstiger. Andersherum kostet Fable das 2,5-Fache.
Was „40 % günstiger“ tatsächlich bedeutet
Die Listenpreissenkung beträgt nur 20 %. Anthropic gibt an, dass der Rest durch Effizienz entsteht: Opus 5.5 „kostet weniger pro Token als Opus 5 und benötigt weniger Tokens pro Aufgabe, was insgesamt zu 40 % geringeren Kosten führt.“
Ein Detail ist hier entscheidend. Anthropic hat die 40 % „bei Standardeinstellungen“ gemessen. Bei Opus 5.5 ist das standardmäßig mittlerer Aufwand, bei Opus 5 war es hoher Aufwand. Wenn Sie Opus 5.5 mit hohem oder maximalem Aufwand betreiben, sparen Sie weniger.
Um die Preise greifbar zu machen, haben wir die Beispielaufgabe aus Anthropics Kostenübersicht genommen und auf jedem Modell berechnet. Die Aufgabe läuft über 40 Durchläufe mit etwa 2,8 Mio. Input-Tokens (davon 90 % aus dem Cache gelesen) und 60.000 Output-Tokens.
| Modell | Input cost | Output cost | Total |
|---|---|---|---|
| Opus 5.5 | $1.62 | $1.20 | $2.82 |
| Opus 5 | $2.66 | $1.50 | $4.16 |
| Fable 5.1 | $3.43 | $3.00 | $6.43 |
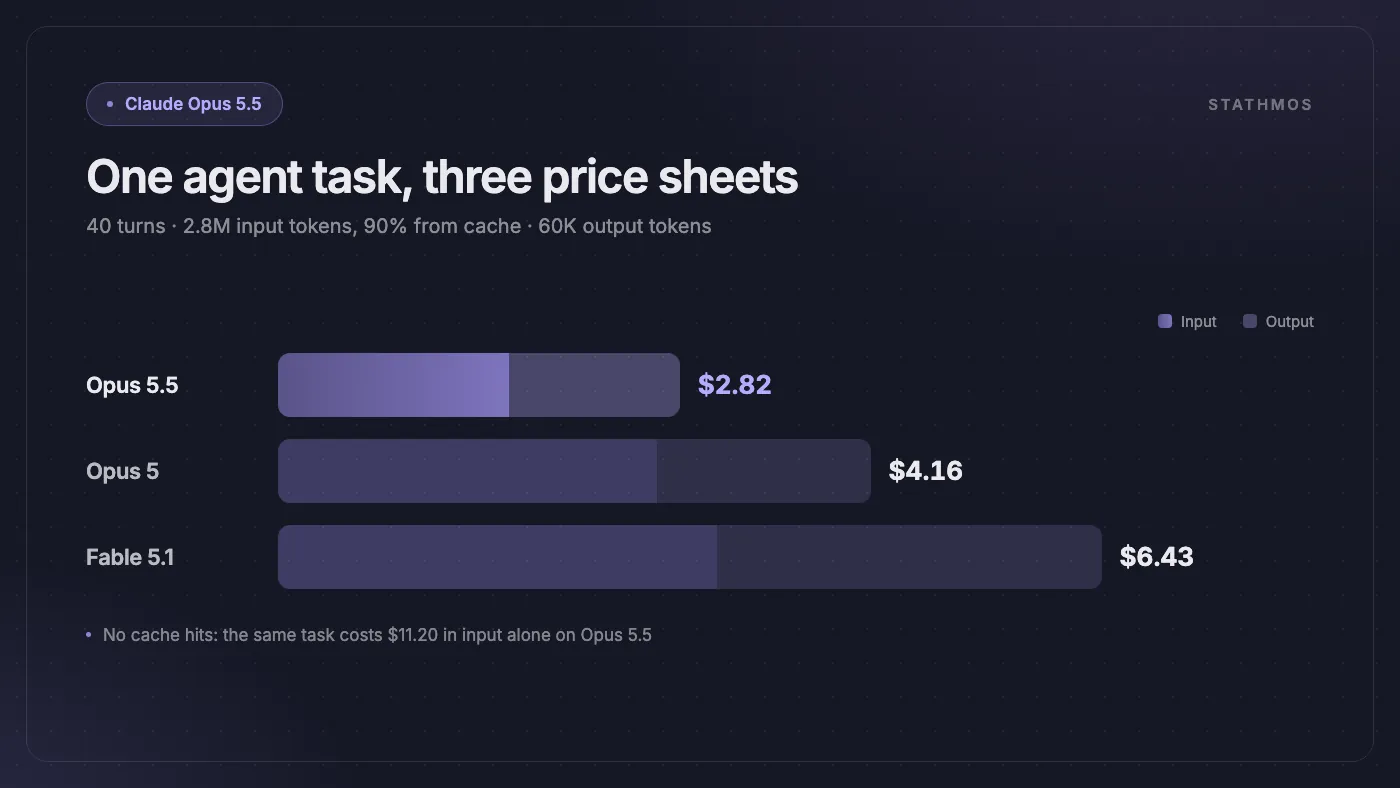
Zwei Hinweise: Wie im Beispiel von Anthropic lässt die Tabelle die Kosten für Cache-Schreibvorgänge weg. Außerdem wird angenommen, dass jedes Modell die gleiche Token-Anzahl verwendet – das ist in der Praxis nicht der Fall. Die Angaben dienen nur als grobe Orientierung, nicht als Angebot.
Caching ist noch wichtiger als die Modellwahl. Die gleiche Aufgabe ohne Cache-Treffer kostet allein im Input $11,20 auf Opus 5.5 – viermal so viel wie die gesamte Aufgabe mit Caching. Wenn Ihre KI-Rechnung hoch ausfällt, prüfen Sie zuerst Ihre Cache-Trefferquote, bevor Sie das Modell wechseln. Weitere Details zu den Kosten finden Sie unter was KI ein E-Commerce-Unternehmen wirklich kostet.
Wie das Modell in Anthropics Benchmarks abschneidet
Dies sind die von Anthropic veröffentlichten Zahlen:
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 |
|---|---|---|---|
| Agentic Coding: Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% |
| Agentic Coding: FrontierCode v1.1 | 54.4% | 50.3% | 48.0% |
| Agentic Coding: CursorBench 4.0 | 57.8% | 51.8% | 46.6% |
| Wissensarbeit: GDPval-AA v2.1 (Elo) | 1846 | 1735 | 1708 |
| Computerbedienung: OSWorld 2.0 (teilweise) | 81.8% | 80.7% | 74.0% |
| Schlussfolgern: Humanity's Last Exam (mit Tools) | 67.7% | 65.6% | 63.6% |
Opus 5.5 liegt in jeder Zeile vorne. Vier Punkte sind zu beachten:
- Diese Werte wurden mit den höchsten Aufwandseinstellungen erzielt. Anthropic hat Opus 5.5 für die meisten Benchmarks mit maximalem Aufwand betrieben, für Terminal-Bench 4.0 mit xhigh. Das entspricht nicht dem mittleren Standard, den die meisten Teams nutzen. Fairerweise gibt Anthropic an, dass Opus 5.5 bei mittlerem Aufwand 54,6 % auf FrontierCode erreicht hat – mehr als alle anderen Modelle.
- Anthropic relativiert die eigenen Vorsprünge. Das Unternehmen sagt, Benchmark-Unterschiede seien „kein verlässlicher Indikator mehr für reale Unterschiede.“ Außerdem heißt es, dass der Abstand zwischen Opus 5.5 und Claude Fable 5.1 im eigenen Einsatz geringer sei als die Werte vermuten lassen.
- Nicht überall liegt es vorn. In Anthropics eigener Übersicht erzielt OpenAI GPT-6 Astra höhere Werte bei AutomationBench (41,4 % vs. 40,0 %) und Terminal-Bench-Science (64,6 % vs. 58,7 %).
- Schwer zu testen. Anthropic schreibt: „Wir sehen Anzeichen, dass Opus 5.5 oft vermutet, evaluiert zu werden.“ Ein weiterer Grund, es mit eigenen realen Aufgaben zu prüfen.
Was unabhängige Tests zeigen
Artificial Analysis, ein unabhängiges Benchmark-Unternehmen, hat Opus 5.5 bereits im eigenen Intelligence Index getestet. Das sind die aktuellen Ergebnisse:
| Modell und Aufwandseinstellung | Intelligence Index | Cost per task |
|---|---|---|
| Opus 5.5 (max) | 58 | $5.98 |
| Opus 5.5 (xhigh) | 56 | |
| Opus 5.5 (high) | 54 | |
| Fable 5.1 (max) | 53 | $7.63 |
| Opus 5.5 (medium, Standard) | 51 | $1.34 |
| Opus 5 (max) | 51 | $5.86 |
Die Kosten pro Aufgabe sind der von Artificial Analysis gewichtete Durchschnitt pro Intelligence-Index-Aufgabe; wo keine Angabe steht, liegen keine veröffentlichten Werte vor.
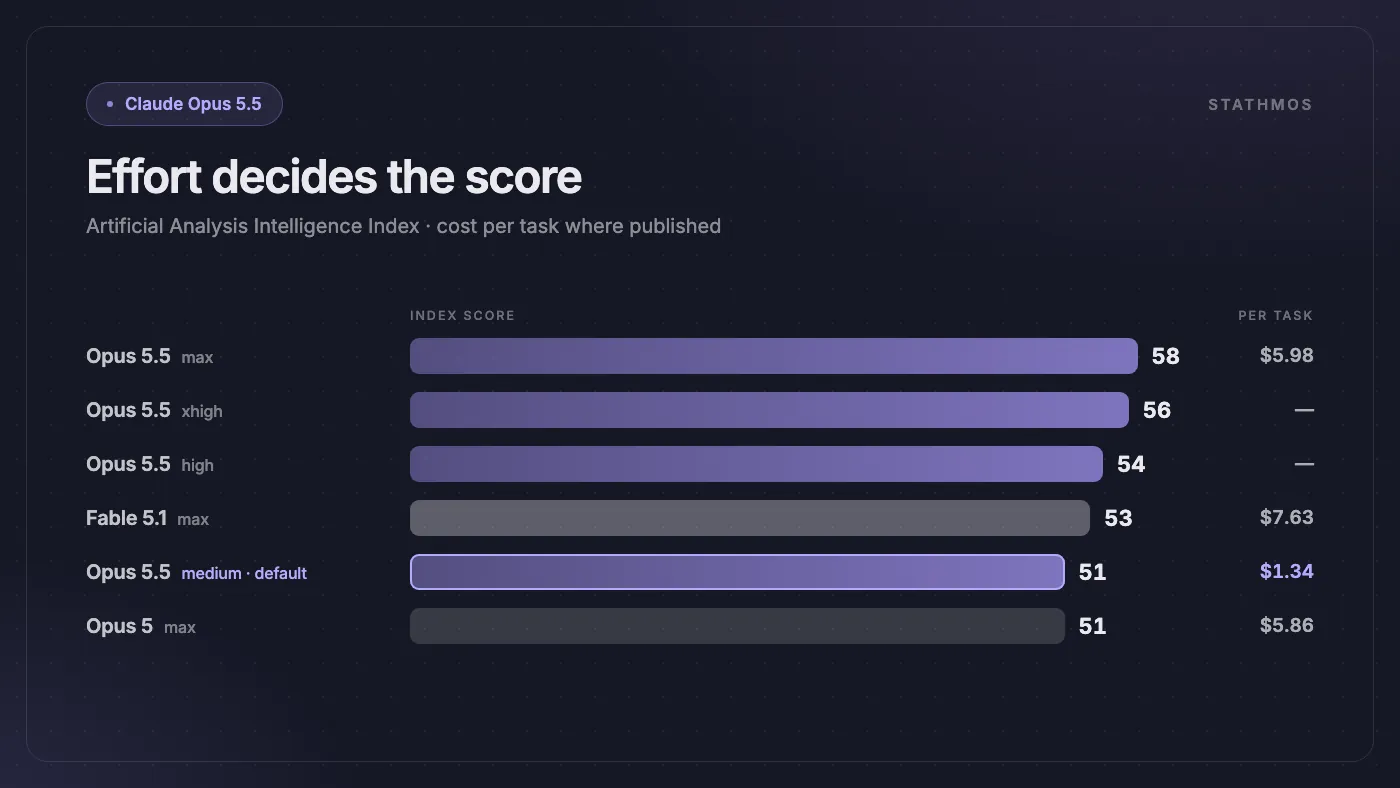
Bei maximalem Aufwand belegt Opus 5.5 den Spitzenplatz im Index und ist dort günstiger als Fable 5.1: 5,98 $ pro Aufgabe gegenüber 7,63 $ bei Fable.
Interessanter ist das Ergebnis weiter unten. Im Standardwert medium erreicht Opus 5.5 einen Score von 51. Das entspricht Opus 5 bei max, liegt aber unter Fable 5.1. Fable wird erst ab hohem Aufwand übertroffen. Medium ist mit 1,34 $ pro Aufgabe deutlich günstiger und für viele Alltagsaufgaben ausreichend. Wer Fable-Niveau bei schwierigen Problemen braucht, muss Aufwand und Kosten erhöhen.
Wie es bei echten Aufgaben aussieht
Das nützlichste Beispiel von Anthropic ist ein interner Test: Opus 5.5 und Fable 5.1 sollten HAProxy, einen verbreiteten Load Balancer, von C nach Rust portieren. Beide Umsetzungen bestanden fast alle Regressionstests von HAProxy. Opus 5.5 war nach 9,5 Stunden fertig, Fable 5.1 nach 12, und die Kosten lagen 51 % niedriger. Das ist ein echter Engineering-Job, kein Puzzle – auch wenn der Test von Anthropic stammt.
Anthropic hat auch erste Kundenrückmeldungen veröffentlicht. GitHub berichtet, dass Opus 5.5 in VS Code „mehr Terminal-Aufgaben als Opus 5 in weniger als der halben Schrittzahl gelöst hat“. Optiver meldet, dass Opus 5.5 bei agentischen Coding-Aufgaben „die Qualität von Opus 5 in etwa der halben Zahl an Turns, Zeit und Output-Tokens erreicht und die Kosten um 40 bis 50 % gesenkt hat“. Das sind erste Erfahrungswerte, keine Audits.
Zwei weitere Änderungen stechen hervor:
- Geschwindigkeit. Anthropic gibt an, dass Opus 5.5 „über 30 % schneller als Opus 5“ antwortet. Es gibt auch einen schnellen Modus (noch Forschungs-Vorschau), der bis zu 2,5-fache Geschwindigkeit bei 8 $ Input und 40 $ Output pro Million Tokens verspricht. Er läuft in Claude Code und über die Claude API, aber nicht auf AWS, Google Cloud oder Microsoft Foundry.
- Schreiben. Laut Anthropic stellt das Modell „die wichtigsten Informationen an den Anfang“ und „verwendet seltener Fachjargon“. Das hilft bei Berichten, Übergaben und allem, was Kund:innen sehen.
Vor dem Umstieg: die Fallstricke
Dieser Abschnitt fehlt in den meisten Vergleichsartikeln. Aus Anthropics Migrationsleitfaden:
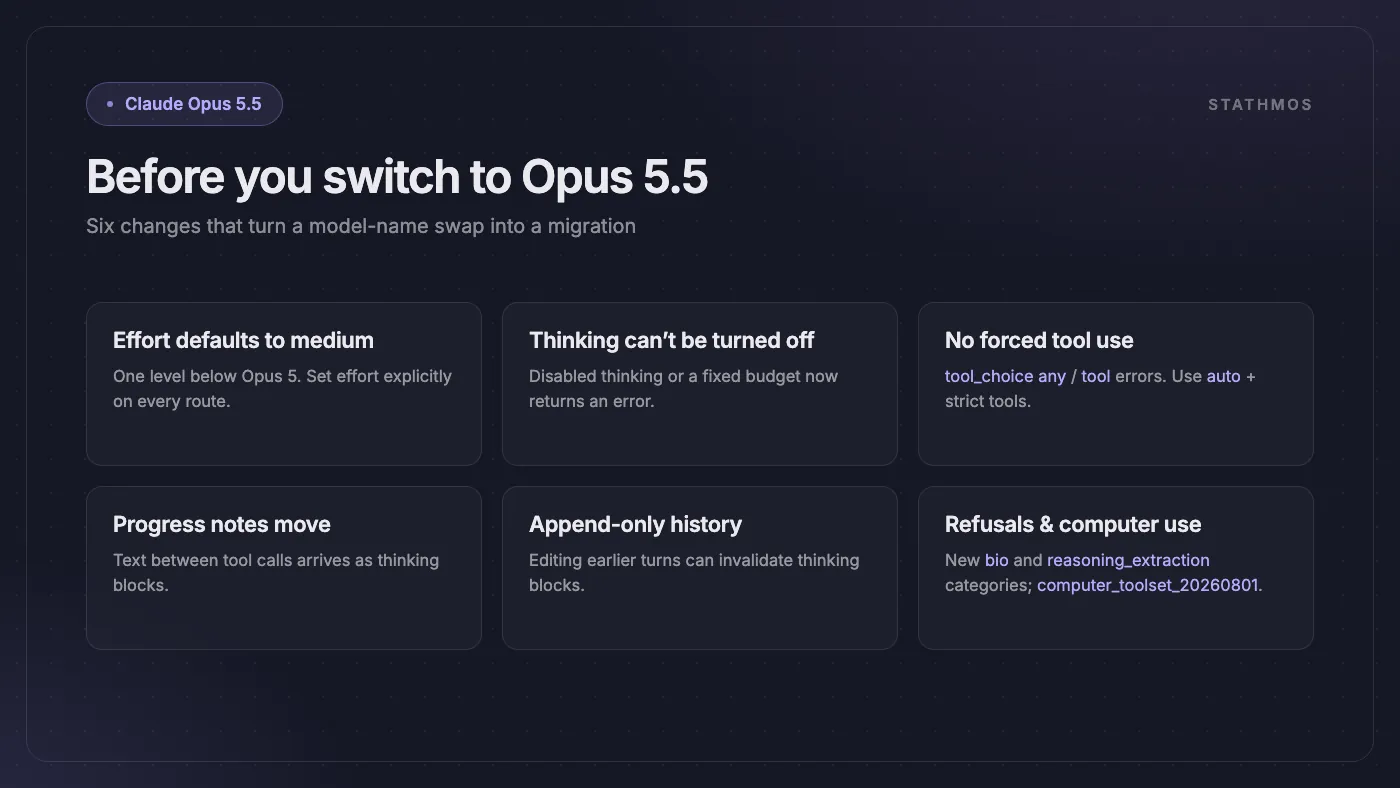
- Standard-Aufwand ist jetzt medium, nicht high. Ohne explizite Einstellung gibt es weniger Thinking als bisher. Das spart Kosten, aber prüfen Sie die Qualität bei den schwierigsten Aufgaben und setzen Sie den Aufwand gezielt.
- Thinking lässt sich nicht mehr abschalten. Anfragen, die Thinking deaktivieren oder ein fixes Thinking-Budget setzen, führen jetzt zu einem Fehler. Nutzen Sie stattdessen die
effort-Einstellung (low bis max). - Erzwungene Tool-Nutzung entfällt.
tool_choiceaufanyoder ein bestimmtes Tool führt jetzt zu einem Fehler. Verwenden Sieautofür strikte Tool-Nutzung oder strukturierte Ausgaben. - Ihre UI könnte still werden. Kurze Fortschrittsnotizen zwischen Tool-Aufrufen erscheinen jetzt als Thinking-Blocks, nicht mehr als Text. Wenn Sie diese Notizen anzeigen, verschwinden sie, sofern Sie die Anzeigeeinstellung nicht anpassen.
- Lassen Sie Platz bei max_tokens. Thinking läuft bei jeder Anfrage, und
max_tokensumfasst Thinking plus Antwort. Bei xhigh oder max empfiehlt Anthropic, mit 64K zu starten. - Konversationen müssen append-only bleiben. Änderungen am Systemprompt, an Tools oder früheren Nachrichten während einer Unterhaltung können Thinking-Blocks ungültig machen. Bei Accounts ab dem 31.08.2026 führt das standardmäßig zu einem Fehler.
- Mehr Refusal-Kategorien. Ihr Code sollte
stop_reason: "refusal"abfangen, inklusive neuer Kategorien wiebioundreasoning_extraction. - Computer use hat ein neues Tool. In der Claude API und bei Google Cloud ersetzt
computer_toolset_20260801das alte Tool. Bei Amazon Bedrock bleibt das alte Tool erhalten.
Nichts davon ist schwierig, aber es ist eine echte Migration, kein Suchen-und-Ersetzen.
Worauf wir weiterhin achten
- Standardwerte vs. Top-Scores. Die Launch-Grafik zeigt max effort. Ihre Rechnung wird meist medium widerspiegeln. Prüfen Sie, was Sie tatsächlich nutzen.
- Fable 5.1 bleibt relevant. Anthropic empfiehlt es weiterhin für besonders anspruchsvolle, langlaufende Agenten-Aufgaben. Nicht ohne Test ersetzen.
- Ersparnisse hängen von Ihrer Architektur ab. Schlechte Caching-Strategien können teurer werden als das falsche Modell.
- Kleinere Modelle folgen. Anthropic kündigt Sonnet 5.5 und Haiku 5.5 „in den nächsten Wochen“ an. Für große Mengen einfacher Aufgaben kann es sich lohnen, darauf zu warten.
So würden wir es umsetzen
- Wählen Sie 10 bis 20 echte Aufgaben aus Ihrem Backlog: etwa einen Bugfix, ein Code Review, ein Plugin-Upgrade, ein Datenimport-Skript oder einen Bericht. Für E-Commerce-Teams eignen sich Aufgaben, die Sie bereits gut kennen, wie ein Checkout-Fehler oder ein Produktkatalog-Import.
- Führen Sie diese Aufgaben sowohl mit Ihrem aktuellen Modell als auch mit Opus 5.5 bei mittlerem Aufwand durch. Vergleichen Sie Qualität, Zeitaufwand und Kosten pro Aufgabe.
- Falls die Qualität nachlässt, testen Sie mit hohem Aufwand, bevor Sie zu Fable zurückkehren. Das empfiehlt auch die Dokumentation von Anthropic.
- Passen Sie die oben genannten API-Änderungen zuerst in einer Entwicklungsumgebung an. Laut Anthropic sollten Sie „in einer Entwicklungsumgebung testen, bevor Sie den Produktivverkehr umstellen“.
- Stellen Sie Ihren Standardverkehr um und behalten Sie Fable 5.1 als Fallback für besonders anspruchsvolle Aufgaben.
Messen Sie die Kosten pro abgeschlossener Aufgabe, nicht pro Anfrage. Eine günstigere Anfrage, die mehr Durchläufe benötigt, ist am Ende nicht günstiger. Das zeigt sich auch beim tatsächlichen ROI agentischer Webentwicklung: Das Modell ist selten der Engpass – entscheidend ist, wie Sie testen und die Ergebnisse prüfen.
Fazit
Für die meisten Teams dürfte Opus 5.5 der neue Standard sein. Die Preise sind niedriger, die Ergebnisse schneller und die Bewertungen stark; ein unabhängiger Test sieht es bei maximalem Aufwand an der Spitze. Verlassen Sie sich aber nicht darauf, dass die Standardeinstellung bei den schwierigsten Aufgaben Fable-Niveau erreicht. Testen Sie mit Ihren eigenen Aufgaben, wählen Sie das Aufwandniveau, das überzeugt, und lassen Sie Ihre Zahlen entscheiden – nicht die Launch-Grafik.
Häufige Fragen
Ist Claude Opus 5.5 besser als Fable 5.1?
Laut Anthropics Benchmarks bei maximalem Aufwand ja, und auch Artificial Analysis sieht Opus 5.5 bei maximalem Aufwand vor Fable 5.1. Bei mittlerem (Standard-)Aufwand liegt es unter Fable 5.1. Für anspruchsvolle Aufgaben ist hoher oder sehr hoher Aufwand nötig. Anthropic empfiehlt Fable 5.1 weiterhin für komplexe, langfristige Agentenaufgaben.
Wie viel günstiger ist Opus 5.5 im Vergleich zu Opus 5 und Fable 5.1?
Opus 5.5 kostet 4 $ pro Million Eingabetokens und 20 $ pro Million Ausgabetokens: 20 % weniger als Opus 5 und 60 % weniger als Fable 5.1. Cache-Lesezugriffe kosten 0,20 $ gegenüber 0,50 $ bei Opus 5. Die von Anthropic angegebenen 40 % Ersparnis gegenüber Opus 5 berücksichtigen auch weniger Tokens pro Aufgabe und wurden mit Standardeinstellungen gemessen.
Welcher Aufwand ist bei Opus 5.5 voreingestellt?
Mittel – eine Stufe unter dem hohen Standardwert von Opus 5 und Fable 5.1. Setzen Sie den Aufwand explizit und erhöhen Sie ihn für komplexe Programmier- und Agentenaufgaben auf hoch oder sehr hoch.
Kann ich einfach den Modellnamen ändern, um auf Opus 5.5 zu wechseln?
Nicht ohne Weiteres. "Thinking" lässt sich nicht deaktivieren, erzwungene Tool-Nutzung führt zu Fehlern, Fortschrittsnotizen werden in "Thinking"-Blöcke verschoben, Konversationen müssen nur angehängt werden, und für Computer-Nutzung ist ein neues Tool in der Claude API und Google Cloud erforderlich. Testen Sie diese Anpassungen zuerst in einer Entwicklungsumgebung.
Sollte ich Opus 5 nicht mehr verwenden?
Planen Sie den Umstieg, aber es besteht kein Zeitdruck. Opus 5 ist als Legacy markiert und laut Anthropic wird es nicht vor dem 24.07.2027 eingestellt. Da Opus 5.5 in jeder Preisposition günstiger ist, sollten die meisten Teams nach Anpassung der API wechseln.
Quellen
- Anthropic: Introducing Claude Opus 5.5
- Anthropic: Introducing Claude Fable 5.1 and Claude Mythos 5.1
- Claude Docs: Models overview
- Claude Docs: Pricing
- Claude Docs: Claude Opus 5 (legacy)
- Claude Docs: What's new in Claude Opus 5.5
- Claude Docs: Migrating to Claude Opus 5.5
- Claude Blog: What a task costs on Opus 5.5
- Artificial Analysis: Claude Opus 5.5 results
- Artificial Analysis: Claude Fable 5.1
- Artificial Analysis: Claude Opus 5
- TechCrunch: Anthropic releases Opus 5.5
Planen Sie den Umstieg auf Opus 5.5?
Wir entwickeln und betreiben AI- und ML-Systeme für Commerce-Teams und können den oben beschriebenen Vergleichstest mit Ihren eigenen Aufgaben durchführen: Ihr Backlog, Ihre Prompts, Ihre Kosten pro abgeschlossener Aufgabe. Wenn Sie Unterstützung bei der Migration oder beim Test wünschen, sprechen Sie uns an.