Prix, scores et documentation vérifiés au 24 septembre 2026.
Anthropic a lancé Claude Opus 5.5 le 22 septembre 2026, avec une annonce marquante : « Opus 5.5 atteint le niveau de Claude Fable 5.1 sur la plupart des tâches et coûte 40 % de moins à l’usage qu’Opus 5. »
Les premiers articles comparatifs sont parus en quelques heures. Certains étaient pertinents. Au moins un indiquait qu’Opus 5.5 n’était pas encore vérifiable. Avant de rédiger cet article, nous avons donc relu l’annonce officielle d’Anthropic, la page de tarification et la documentation de migration, consulté les premiers tests indépendants et vérifié chaque chiffre.
Voici ce qui est avéré, ce qui reste à confirmer, et ce que nous ferions à la place d’une équipe de développement aujourd’hui.
En résumé
- Passez Opus 5.5 en modèle par défaut pour le code, les agents et les tâches courantes. La documentation Anthropic indique désormais : « Si vous hésitez sur le modèle à utiliser, commencez par Claude Opus 5.5 pour la plupart des charges. »
- Gardez Fable 5.1 pour les usages où il a déjà fait ses preuves. Anthropic continue de recommander Fable « pour les raisonnements complexes, les agents sur le long terme, ou si vos évaluations sur Claude Opus 5.5 à effort élevé restent insuffisantes. »
- Préparez la sortie d’Opus 5, sans urgence. Il est désormais marqué « Legacy » dans la documentation Anthropic, Opus 5.5 est moins cher sur chaque ligne tarifaire, et Anthropic annonce qu’Opus 5 ne sera pas retiré avant le 24 juillet 2027.
- Surveillez le réglage d’effort. Le réglage par défaut (moyen) et les meilleurs scores de benchmark (effort maximal) ne donnent pas les mêmes résultats. Détails ci-dessous.
- Prévoyez du temps pour la migration. L’API comporte des changements majeurs. Changer uniquement le nom du modèle peut casser des intégrations.
Quel modèle pour quel usage ?
Si vous ne deviez lire qu’un seul tableau, choisissez celui-ci. Il s’agit de notre recommandation, fondée sur les indications d’Anthropic et les résultats indépendants détaillés plus bas.
| Tâche | Commencez par | Effort |
|---|---|---|
| Développement courant, relecture de code, rapports | Opus 5.5 | Moyen (par défaut) |
| Bugs complexes, refontes multi-fichiers, intégrations délicates | Opus 5.5 | Élevé, puis très élevé |
| Agents autonomes longue durée, raisonnements les plus complexes | Fable 5.1, après avoir testé Opus 5.5 en élevé | Élevé ou supérieur |
| Trafic Opus 5 existant | Passez à Opus 5.5 une fois les modifications de l’API corrigées | Définissez-le explicitement |
| Tâches simples à fort volume (étiquetage, classification) | Attendez Sonnet 5.5 ou Haiku 5.5 | Faible |
Les trois modèles côte à côte
| Opus 5.5 | Opus 5 | Fable 5.1 | |
|---|---|---|---|
| Publié | 2026-09-22 | 2026-07-24 | 2026-09-01 |
| Entrée (par 1M de jetons) | $4 | $5 | $10 |
| Sortie (par 1M de jetons) | $20 | $25 | $50 |
| Lectures du cache (par 1M de jetons) | $0.20 | $0.50 | $0.25 |
| Fenêtre de contexte | 1M | 1M | 1M |
| Sortie maximale | 128K | 128K | 128K |
| Effort par défaut | medium | high | high |
Par rapport à Opus 5, les prix d’entrée et de sortie d’Opus 5.5 sont inférieurs de 20 %, et les lectures du cache de 60 %. Par rapport à Fable 5.1, l’entrée et la sortie sont inférieures de 60 %. Autrement dit, Fable coûte 2,5 fois plus cher.
Ce que signifie réellement « 40 % moins cher »
La baisse du prix catalogue n’est que de 20 %. Anthropic précise que le reste provient de l’efficacité : Opus 5.5 « coûte moins par jeton qu’Opus 5 et utilise moins de jetons par tâche, ce qui aboutit à une baisse de 40 % des coûts ».
Un détail compte ici. Anthropic a mesuré ces 40 % « avec les paramètres par défaut ». Pour Opus 5.5, le défaut est un effort moyen. Pour Opus 5, c’était élevé. Si vous exécutez Opus 5.5 en élevé ou maximum, l’économie sera moindre.
Pour illustrer les prix, nous avons repris la tâche exemple de l’explication d’Anthropic et l’avons chiffrée sur chaque modèle. La tâche comprend 40 tours, environ 2,8 millions de jetons en entrée (90 % lus depuis le cache) et 60 000 jetons en sortie.
| Modèle | Input cost | Output cost | Total |
|---|---|---|---|
| Opus 5.5 | $1.62 | $1.20 | $2.82 |
| Opus 5 | $2.66 | $1.50 | $4.16 |
| Fable 5.1 | $3.43 | $3.00 | $6.43 |
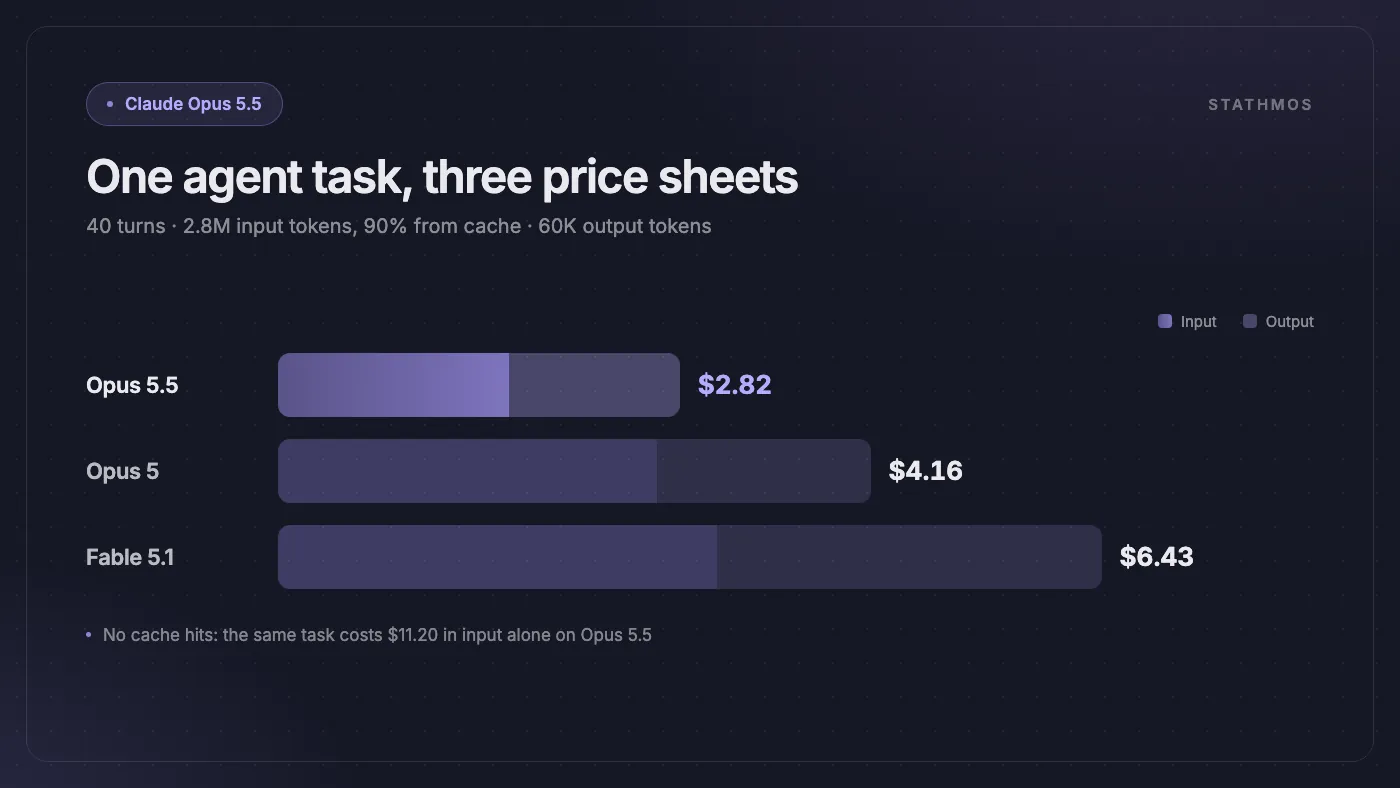
Deux réserves. Comme dans l’exemple d’Anthropic, le tableau ne prend pas en compte le coût des écritures dans le cache. Il suppose aussi que chaque modèle utilise le même nombre de jetons, ce qui n’arrive pas en pratique. À considérer comme un ordre de grandeur, pas un devis.
Le caching compte encore plus que le choix du modèle. La même tâche sans aucun accès au cache coûte 11,20 $ rien qu’en entrée sur Opus 5.5, soit quatre fois le coût total avec caching. Si votre facture IA vous semble élevée, vérifiez d’abord votre taux de cache avant de changer de modèle. Nous détaillons le reste des coûts dans ce que coûte réellement l’IA à une entreprise e-commerce.
Résultats sur les benchmarks d’Anthropic
Voici les chiffres publiés par Anthropic :
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 |
|---|---|---|---|
| Agentic coding : Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% |
| Agentic coding : FrontierCode v1.1 | 54.4% | 50.3% | 48.0% |
| Agentic coding : CursorBench 4.0 | 57.8% | 51.8% | 46.6% |
| Travail de connaissance : GDPval-AA v2.1 (Elo) | 1846 | 1735 | 1708 |
| Utilisation d’ordinateur : OSWorld 2.0 (partiel) | 81.8% | 80.7% | 74.0% |
| Raisonnement : Humanity’s Last Exam (avec outils) | 67.7% | 65.6% | 63.6% |
Opus 5.5 arrive en tête sur chaque ligne ici. Quatre points à retenir :
- Ces résultats utilisent les réglages d'effort maximum. Anthropic a exécuté Opus 5.5 en mode max pour la plupart des tests, et en xhigh pour Terminal-Bench 4.0. Ce n'est pas le réglage moyen par défaut utilisé par la majorité des équipes. Pour être précis, Anthropic indique aussi qu'à effort moyen, Opus 5.5 a obtenu 54,6 % sur FrontierCode, mieux que tous les autres modèles.
- Anthropic relativise ses propres écarts. L'entreprise indique que les écarts sur les benchmarks « sont devenus un indicateur moins fiable des différences réelles en production ». Elle précise aussi que dans ses propres usages, « l'écart entre Opus 5.5 et Claude Fable 5.1 est plus faible que ce que ces scores laissent penser ».
- Il ne gagne pas partout. Sur le graphique d'Anthropic, GPT-6 Astra d'OpenAI fait mieux sur AutomationBench (41,4 % contre 40,0 %) et Terminal-Bench-Science (64,6 % contre 58,7 %).
- Les tests sont complexes. Selon l'annonce d'Anthropic : « Nous constatons qu'Opus 5.5 soupçonne souvent qu'il est évalué. » C'est une raison de plus de le tester sur vos propres cas concrets.
Ce que montrent les tests indépendants
Artificial Analysis, société indépendante de benchmarking, a déjà testé Opus 5.5 sur son Intelligence Index. Voici ce qu'elle rapporte à ce jour :
| Modèle et niveau d'effort | Intelligence Index | Cost per task |
|---|---|---|
| Opus 5.5 (max) | 58 | $5.98 |
| Opus 5.5 (xhigh) | 56 | |
| Opus 5.5 (high) | 54 | |
| Fable 5.1 (max) | 53 | $7.63 |
| Opus 5.5 (medium, par défaut) | 51 | $1.34 |
| Opus 5 (max) | 51 | $5.86 |
Le coût par tâche correspond à la moyenne pondérée d'Artificial Analysis pour chaque tâche de l'Intelligence Index ; il est laissé vide si non publié pour ce réglage.
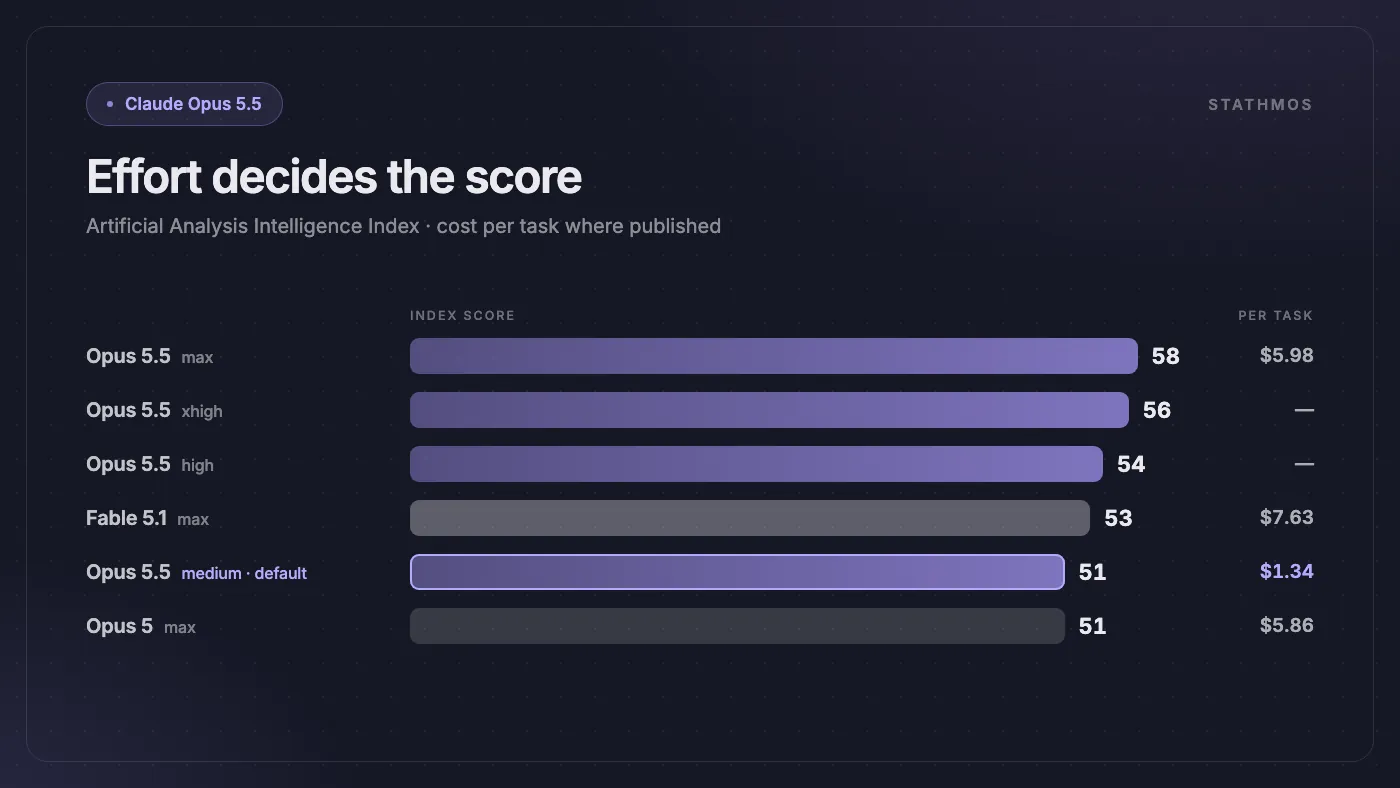
À effort maximum, Opus 5.5 prend la première place de l'index, et son coût d'exécution y est inférieur à celui de Fable 5.1 : 5,98 $ par tâche, contre 7,63 $ pour Fable.
Le point le plus utile se situe plus bas. Au réglage medium par défaut, Opus 5.5 a obtenu 51. C'est le même score qu'Opus 5 à effort max, mais inférieur à Fable 5.1. Il ne dépasse Fable qu'à partir du niveau high. Medium coûte bien moins cher, à 1,34 $ par tâche, et suffira pour de nombreux usages courants. Mais pour viser les résultats de Fable sur des problèmes complexes, prévoyez d'augmenter l'effort — et le coût.
Ce que cela donne sur des cas réels
L'exemple le plus parlant partagé par Anthropic est un test interne. Opus 5.5 et Fable 5.1 devaient réécrire HAProxy, un répartiteur de charge très utilisé, du C vers Rust. Les deux versions ont passé presque tous les tests de non-régression de HAProxy. Opus 5.5 a terminé en 9,5 heures, contre 12 pour Fable 5.1, pour un coût inférieur de 51 %. Ce n'est qu'une tâche, menée par Anthropic, mais c'est un vrai travail d'ingénierie, pas un exercice.
Anthropic a aussi publié des retours clients préliminaires. GitHub indique que dans VS Code, Opus 5.5 « a résolu plus de tâches terminales qu'Opus 5 en moins de la moitié des étapes ». Optiver précise que sur ses tâches de codage agentique, il « a égalé la qualité d'Opus 5 en environ la moitié des tours, du temps et des tokens générés, réduisant le coût de 40 à 50 % ». À lire comme des retours initiaux, pas comme des audits.
Deux autres évolutions sont à noter :
- Vitesse. Anthropic annonce qu'Opus 5.5 « génère des réponses plus de 30 % plus vite qu'Opus 5 ». Un mode rapide, encore en préversion, promet jusqu'à 2,5 fois la vitesse, à 8 $ en entrée et 40 $ en sortie par million de tokens. Il fonctionne dans Claude Code et via l'API Claude, mais pas sur AWS, Google Cloud ni Microsoft Foundry.
- Rédaction. Selon Anthropic, le modèle « place l'information essentielle en tête » et « emploie moins de jargon ». Cela facilite les rapports, passations et tout ce qui est destiné à des clients.
Avant de migrer : les points de vigilance
C'est la section que la plupart des comparatifs omettent. Extraits du guide de migration d'Anthropic :
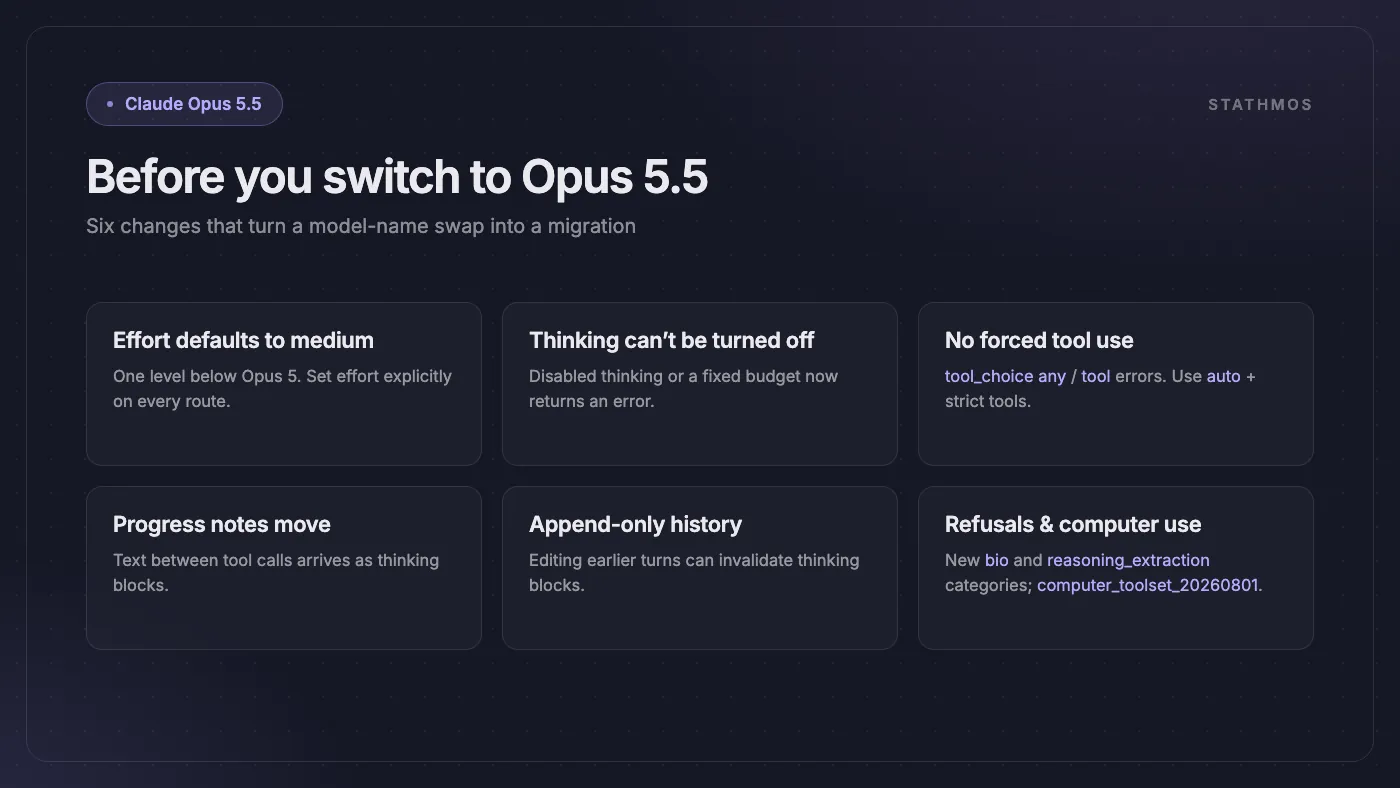
- L'effort par défaut est désormais medium, plus high. Si vous ne définissez pas l'effort, la réflexion sera moindre que ce à quoi vous êtes habitué. C'est moins cher, mais vérifiez la qualité sur vos tâches les plus exigeantes et fixez l'effort explicitement.
- La réflexion ne peut plus être désactivée. Les requêtes qui désactivent la réflexion ou fixent un budget de réflexion retournent désormais une erreur. Utilisez plutôt le paramètre
effort(de low à max). - L'utilisation forcée d'un outil n'est plus possible.
tool_choiceréglé suranyou sur un outil précis renvoie désormais une erreur. Utilisezautopour une utilisation stricte des outils ou des sorties structurées. - Votre interface peut devenir silencieuse. Les notes de progression courtes générées entre deux appels d'outil arrivent désormais sous forme de blocs de réflexion, et non de texte. Si vous affichez ces notes à l'utilisateur, elles disparaîtront sauf à modifier le paramètre d'affichage.
- Prévoyez de la marge dans max_tokens. La réflexion s'exécute à chaque requête, et
max_tokenscouvre la réflexion plus la réponse. Pour xhigh ou max, Anthropic recommande de commencer à 64K. - Gardez les conversations append-only. Modifier le prompt système, les outils ou les messages précédents en cours de conversation peut invalider les blocs de réflexion. Pour les comptes créés à partir du 31/08/2026, cela renverra une erreur par défaut.
- Plus de catégories de refus. Votre code doit gérer
stop_reason: "refusal", y compris les nouvelles catégories commebioetreasoning_extraction. - L'usage informatique dispose d'un nouvel outil. Sur l'API Claude et Google Cloud, l'ancien outil est remplacé par
computer_toolset_20260801. Sur Amazon Bedrock, l'ancien outil reste disponible.
Rien de tout cela n'est complexe, mais il s'agit bien d'une migration, pas d'un simple remplacement.
Ce à quoi nous restons attentifs
- Réglages par défaut vs scores maximum. Le graphique de lancement montre l'effort max. Votre facture reflétera probablement le mode medium. Vérifiez bien le réglage utilisé.
- Fable 5.1 reste pertinent. Anthropic continue de le recommander pour les tâches d’agent complexes et longues. Ne l’abandonnez pas sans l’avoir testé.
- Les économies dépendent de votre configuration. Un mauvais cache peut vous coûter plus cher qu’un mauvais choix de modèle.
- Des modèles plus légers arrivent. Anthropic annonce que Sonnet 5.5 et Haiku 5.5 suivront « dans les prochaines semaines ». Pour des tâches simples à fort volume, il peut être pertinent de les attendre.
Notre méthode de déploiement
- Sélectionnez 10 à 20 tâches réelles dans votre backlog : correction de bug, revue de code, mise à jour d’un plugin, script d’import de données, rapport. Pour les équipes e-commerce, privilégiez des cas que vous maîtrisez déjà, comme un bug sur le checkout ou l’import d’un catalogue produit.
- Exécutez-les sur votre modèle actuel et sur Opus 5.5 avec un niveau d’effort moyen. Comparez la qualité, le temps et le coût par tâche.
- Si la qualité baisse, essayez un niveau d’effort élevé avant de revenir à Fable. C’est aussi la recommandation de la documentation Anthropic.
- Adaptez d’abord les changements d’API ci-dessus dans un environnement de développement. Le guide Anthropic recommande de « tester dans un environnement de développement avant de basculer le trafic en production ».
- Basculez votre trafic par défaut et gardez Fable 5.1 en secours pour les tâches les plus complexes.
Mesurez le coût par tâche terminée, pas par requête. Une requête moins chère qui nécessite plus d’itérations n’est pas plus économique. C’est la même leçon que lors de notre analyse du véritable ROI du développement web agentique : le modèle n’est que rarement le goulot d’étranglement, c’est votre méthode de test et de validation qui compte.
À retenir
Pour la plupart des équipes, Opus 5.5 s’impose comme nouveau standard : prix plus bas, sorties plus rapides, bons scores, et un test indépendant le place en tête à effort maximal. Mais ne supposez pas que le réglage par défaut donne des résultats comparables à Fable sur les cas difficiles. Testez sur vos propres tâches, choisissez le niveau d’effort qui tient la route, et laissez vos chiffres décider, pas le graphique de lancement.
Questions fréquentes
Opus 5.5 de Claude est-il meilleur que Fable 5.1 ?
Sur les benchmarks Anthropic à effort maximal, oui, et Artificial Analysis place aussi Opus 5.5 au-dessus de Fable 5.1 à effort maximal. À effort moyen (par défaut), il reste en dessous de Fable 5.1 : pour les tâches les plus exigeantes, il faut donc augmenter l’effort. Anthropic recommande toujours Fable 5.1 pour les travaux d’agent complexes sur le long terme.
Opus 5.5 est-il vraiment moins cher qu’Opus 5 et Fable 5.1 ?
Opus 5.5 coûte 4 $ en entrée et 20 $ en sortie par million de tokens : 20 % de moins qu’Opus 5 et 60 % de moins que Fable 5.1. La lecture du cache coûte 0,20 $ contre 0,50 $ sur Opus 5. Les 40 % d’économie annoncés par Anthropic incluent aussi une réduction du nombre de tokens par tâche, mesurée avec les réglages par défaut.
Quel est l’effort par défaut sur Opus 5.5 ?
Moyen, soit un niveau en dessous du réglage élevé par défaut sur Opus 5 et Fable 5.1. Il faut définir l’effort explicitement et le passer à élevé ou très élevé pour les tâches complexes (code, agents).
Puis-je simplement changer le nom du modèle pour passer à Opus 5.5 ?
Non, pas sans risque. Le raisonnement ne peut pas être désactivé, l’utilisation forcée d’outils renvoie une erreur, les notes de progression sont déplacées dans des blocs de réflexion, les conversations doivent être en ajout uniquement, et l’utilisation d’ordinateur nécessite un nouvel outil sur l’API Claude et Google Cloud. Corrigez ces points d’abord dans un environnement de développement.
Dois-je arrêter d’utiliser Opus 5 ?
Préparez la migration, mais rien d’urgent. Opus 5 est désormais marqué Legacy et Anthropic indique qu’il ne sera pas retiré avant le 24/07/2027. Opus 5.5 étant moins cher sur chaque ligne tarifaire, la plupart des équipes devraient migrer une fois les changements API traités.
Sources
- Anthropic: Introducing Claude Opus 5.5
- Anthropic: Introducing Claude Fable 5.1 and Claude Mythos 5.1
- Claude Docs: Models overview
- Claude Docs: Pricing
- Claude Docs: Claude Opus 5 (legacy)
- Claude Docs: What's new in Claude Opus 5.5
- Claude Docs: Migrating to Claude Opus 5.5
- Claude Blog: What a task costs on Opus 5.5
- Artificial Analysis: Claude Opus 5.5 results
- Artificial Analysis: Claude Fable 5.1
- Artificial Analysis: Claude Opus 5
- TechCrunch: Anthropic releases Opus 5.5
Vous envisagez de passer à Opus 5.5 ?
Nous concevons et exploitons des systèmes d’IA et de ML pour les équipes e-commerce, et pouvons réaliser le test comparatif ci-dessus sur vos propres tâches : votre backlog, vos prompts, votre coût par tâche terminée. Si vous souhaitez un accompagnement pour la migration ou le test, contactez-nous.